n8n 中文版:企业流程自动化方案与操作说明
基于开源 n8n 的中文适配版本,私有化部署在企业自己的服务器上,接入 DeepSeek 等国产大模型。说明部署方法,并用经营日报和询价报价两个示例演示具体操作。
- 适合
- 有固定规则、每天重复、跨多个系统的业务流程
- 部署方式
- Docker Compose 部署到企业服务器或私有云
- 示例场景
- 每日经营日报、客户询价转报价草稿
- 平台版本
- n8n 2.42.6 中文适配版
方案概述
n8n 是一款开源的工作流自动化平台,用拖拽节点的方式连接系统、处理数据、调用 AI。官方版本只有英文界面,部署和模型接入也以海外服务为主,国内企业落地时常卡在三件事上:
- 业务人员看不懂英文界面,最后只能靠 IT 一个人维护。
- 订单、客户、财务数据要留在企业自己的服务器上,不能放到公有云。
- 大模型接入、流程编排、人工审批,每一步都要从头搭。
本方案由三部分组成:
- 中文适配版平台:界面、提示信息、节点分类中文化,默认中文与北京时间。适配版本公开维护,持续合并上游更新。
- 私有化部署:用 Docker Compose 部署到企业内网或私有云,数据留在企业内部。
- 进驻式实施:工程师进驻业务现场,从一个具体流程做起,跑通后交给企业团队维护。
下面的演示视频约 2 分钟,依次介绍中文界面、两个示例工作流、AI 助手和私有化部署架构。
适用场景
适合有固定规则、每天重复、跨多个系统的流程。下表是制造与贸易企业最常见的起步场景:
| 场景 | 触发方式 | 自动处理 | 输出 |
|---|---|---|---|
| 客户询价转报价 | 收到询价邮件或表单 | AI 提取规格与数量,匹配价目表,金额超限转审批 | 报价草稿、审批待办 |
| 每日经营日报 | 每天定时 | 读取 ERP 订单,按区域、产品汇总 | 推送到企业微信群 |
| 订单同步 | 电商或 CRM 新订单 | 字段映射、校验、去重 | 写入 ERP |
| 客户问答 | 官网或企业微信消息 | 检索产品手册,生成回复草稿 | 销售确认后发送 |
平台能力
- 中文界面:菜单、表单、提示信息、节点分类中文化,业务人员可以直接上手。
- 可视化编排:400 多个集成节点,拖拽连线即可搭流程;需要时可以写 JavaScript 或 Python。
- 国产大模型:内置 DeepSeek 节点,也可以接入任何兼容 OpenAI 接口的模型服务或本地模型。
- AI 助手:用中文描述需求,AI 助手查找已有资源、规划节点,关键操作需人工批准。
- 内置数据表:订单、线索、价目表等可以直接存在平台里,工作流直接读写。
- 执行记录:每次运行的输入、输出和耗时都有记录,失败时能定位到具体节点。
- MCP 接口:Claude、Cursor 等 AI 工具可以通过 MCP 调用你公开的工作流。
私有化部署
标准部署包含三个容器:HTTPS 网关(Caddy,自动签发证书)、n8n 主服务和外部任务执行器(隔离运行代码节点)。主服务按需连接企业内部的 ERP、数据库,以及大模型服务。
部署前准备
- 一台 Linux 服务器(建议 4 核 8 GB 起),已安装 Docker 与 Docker Compose。
- 开放 80 和 443 端口,准备一个域名并解析到服务器,例如
n8n.example.com。 - 生成执行器通信密钥:
openssl rand -hex 32。
部署步骤
新建目录,写入
Caddyfile,把域名改成实际域名:n8n.example.com { reverse_proxy n8n-main:5678 }写入
docker-compose.yml。以下为生产环境示例,密钥通过.env注入:services: caddy: image: caddy:2 restart: unless-stopped ports: ["80:80", "443:443"] volumes: - ./Caddyfile:/etc/caddy/Caddyfile:ro - caddy_data:/data depends_on: [n8n] n8n: image: deluxebear/n8n:latest container_name: n8n-main restart: unless-stopped environment: - NODE_ENV=production - N8N_DEFAULT_LOCALE=zh-CN - TZ=Asia/Shanghai - GENERIC_TIMEZONE=Asia/Shanghai - N8N_HOST=n8n.example.com - N8N_PROTOCOL=https - WEBHOOK_URL=https://n8n.example.com/ - N8N_PROXY_HOPS=1 - N8N_DIAGNOSTICS_ENABLED=false - N8N_VERSION_NOTIFICATIONS_ENABLED=false - N8N_RUNNERS_MODE=external - N8N_RUNNERS_BROKER_LISTEN_ADDRESS=0.0.0.0 - N8N_RUNNERS_AUTH_TOKEN=${N8N_RUNNERS_AUTH_TOKEN} volumes: - n8n_data:/home/node/.n8n task-runners: image: deluxebear/runners:latest restart: unless-stopped environment: - N8N_RUNNERS_TASK_BROKER_URI=http://n8n-main:5679 - N8N_RUNNERS_AUTH_TOKEN=${N8N_RUNNERS_AUTH_TOKEN} - TZ=Asia/Shanghai depends_on: [n8n] volumes: n8n_data: caddy_data:在同一目录创建
.env,写入N8N_RUNNERS_AUTH_TOKEN=上一步生成的密钥,然后执行docker compose up -d启动,用docker compose ps查看状态。浏览器访问
https://n8n.example.com,按提示创建管理员账号。新建一个简单工作流并手动执行一次,确认主服务和执行器都正常。
日常运维:docker compose logs -f n8n 查看日志,docker compose pull 后再 docker compose up -d 完成升级。数据保存在 n8n_data 卷中,建议每天备份。
中文适配版基于上游 n8n 二次开发。生产与商业部署前,需要根据实际使用方式评估上游许可和可用功能范围,测试用的配置不能直接作为生产交付配置。
登录与界面
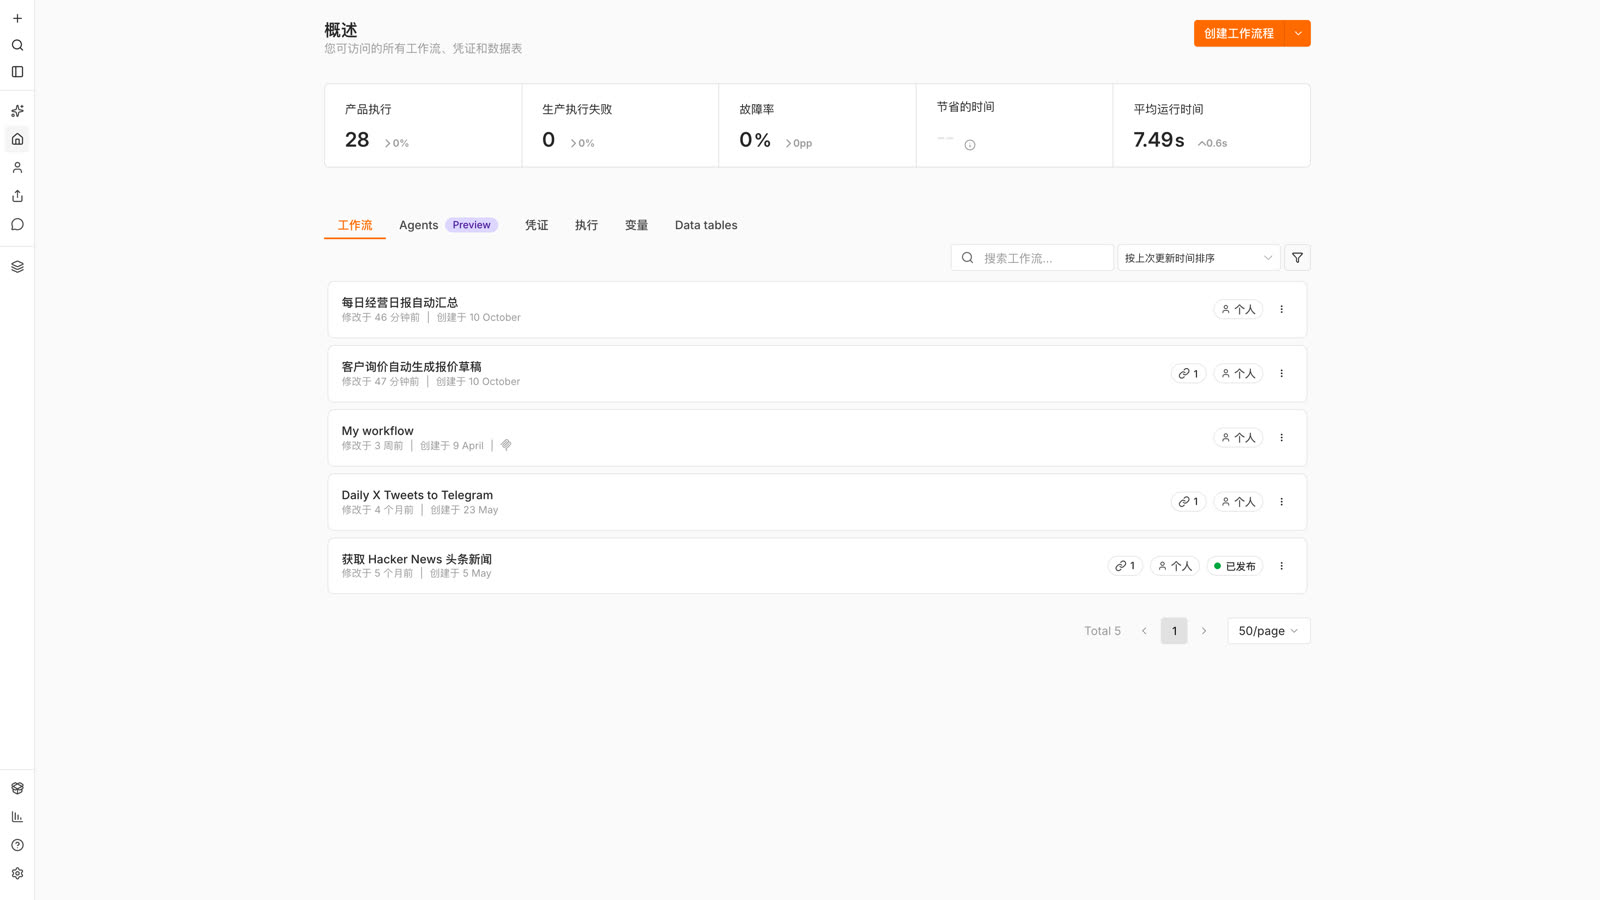
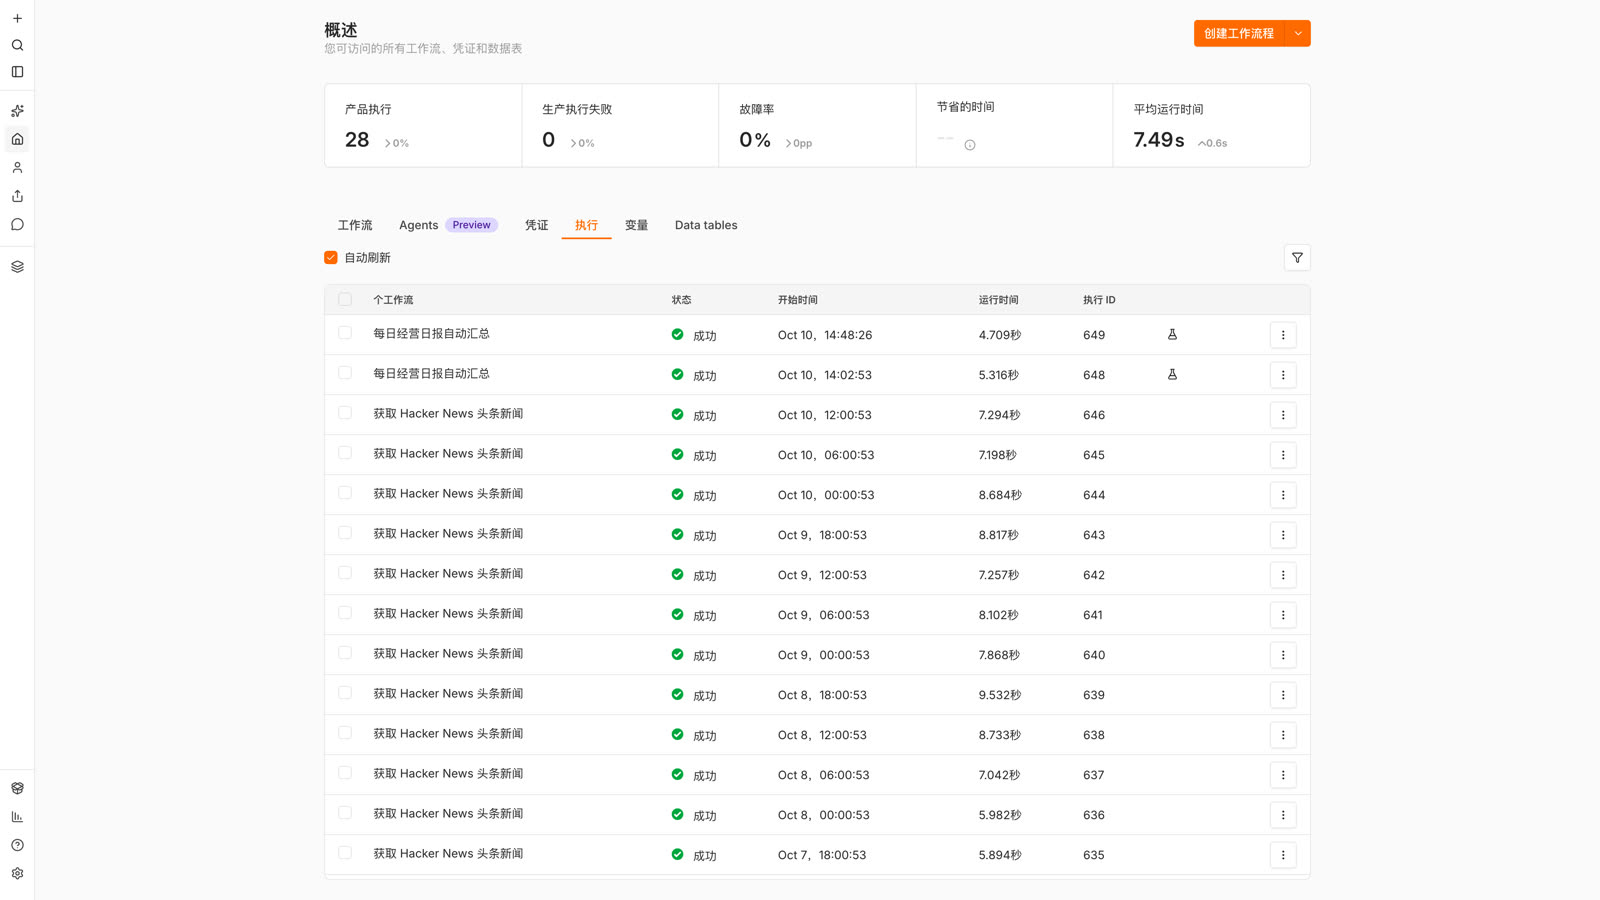
登录后进入「概述」页。顶部汇总近期的执行次数、失败次数、故障率和平均运行时间,下方的标签页依次是工作流、凭证、执行记录和数据表。
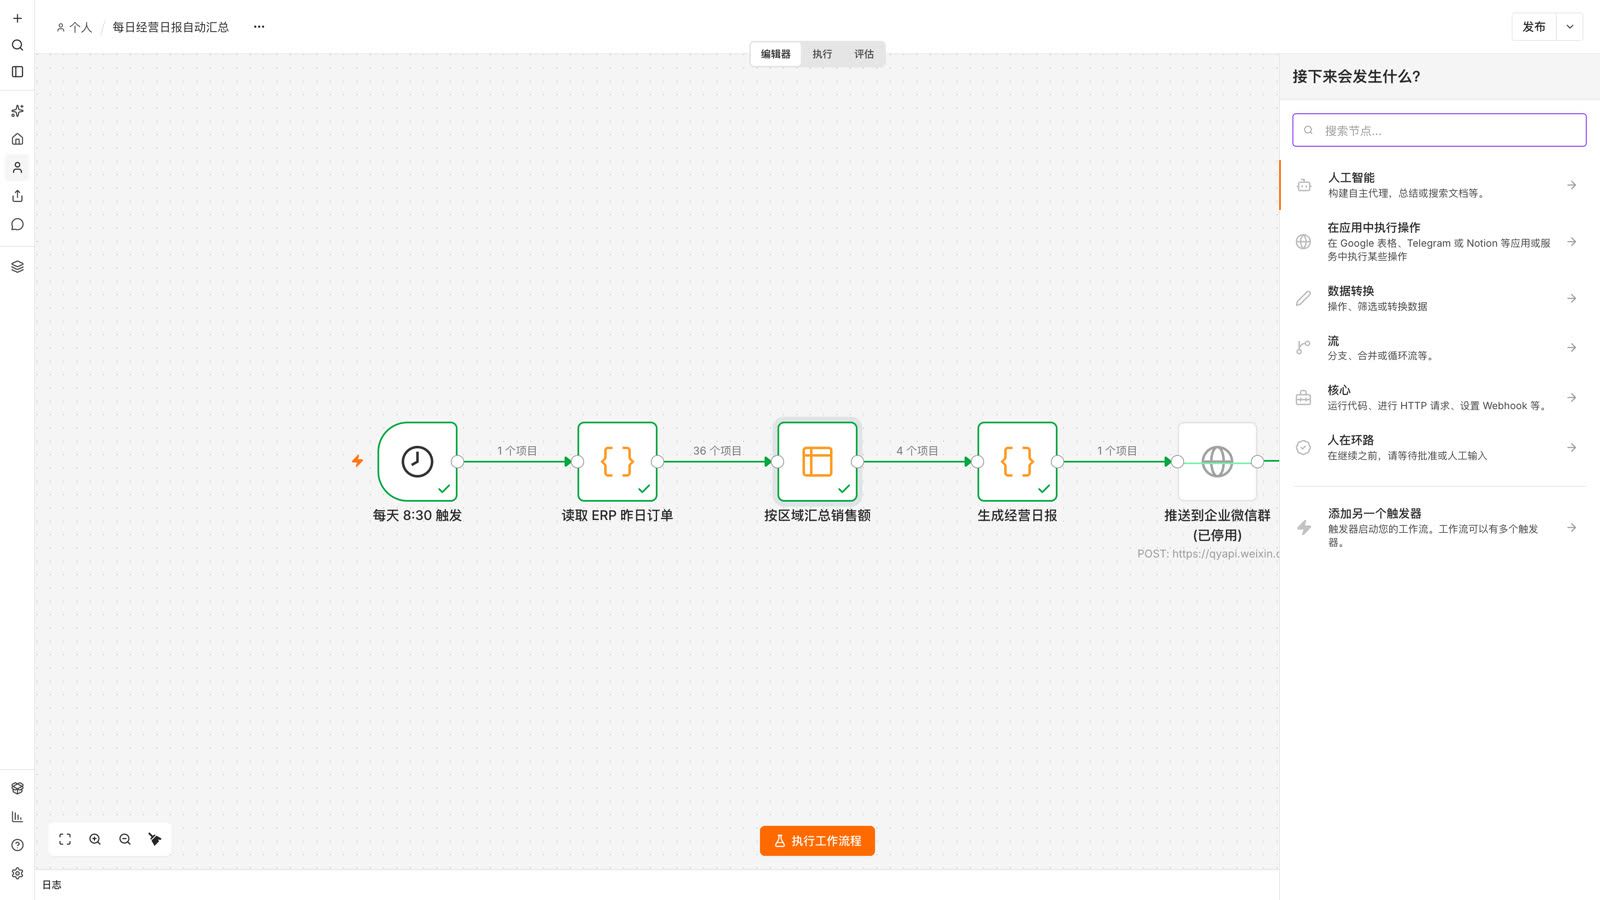
点击右上角「创建工作流程」进入画布,再点击画布上的「+」打开节点面板。节点按人工智能、在应用中执行操作、数据转换、流程、核心、人在环路等中文分类排列。
示例一:每日经营日报
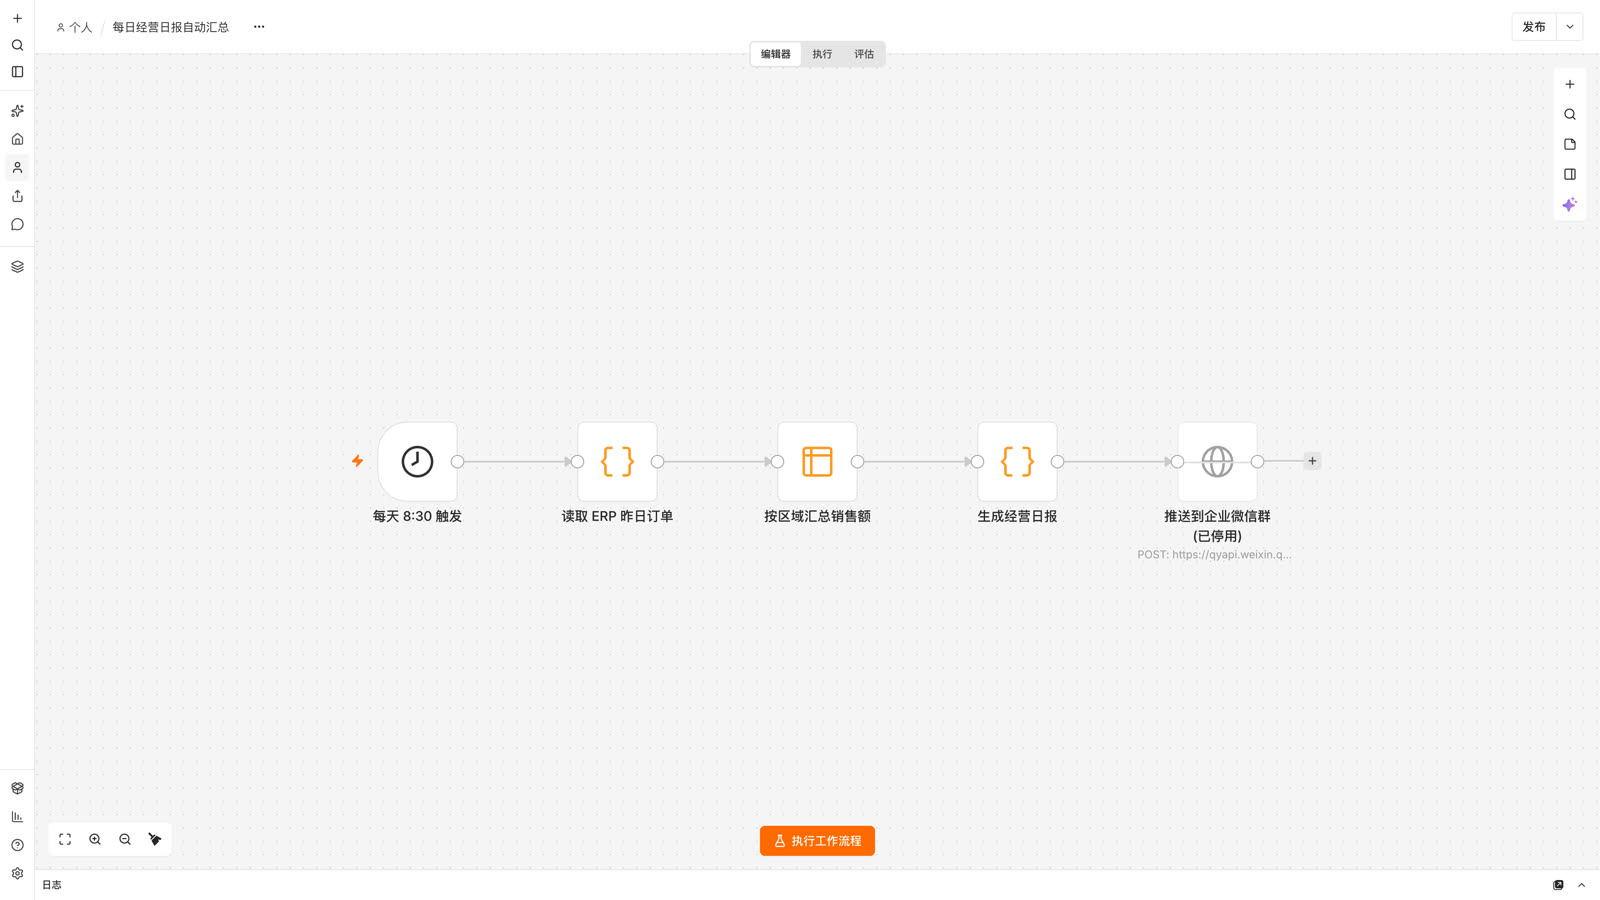
这个工作流每天早上 8:30 自动运行:读取 ERP 昨日订单,按区域汇总销售额,生成一段日报文字,推送到企业微信群。图中订单为示例数据。
搭建步骤
- 添加「定时触发」节点(Schedule Trigger),触发规则选「每天」,时间设为 8:30。
- 添加读取订单的节点。生产环境用「HTTP 请求」节点调用 ERP 接口,或用 MySQL、SQL Server 节点直连数据库;示例中用代码节点生成示例订单。
- 添加「汇总」节点(Summarize),汇总字段选「金额」求和、「订单号」计数,分组字段填「区域」。
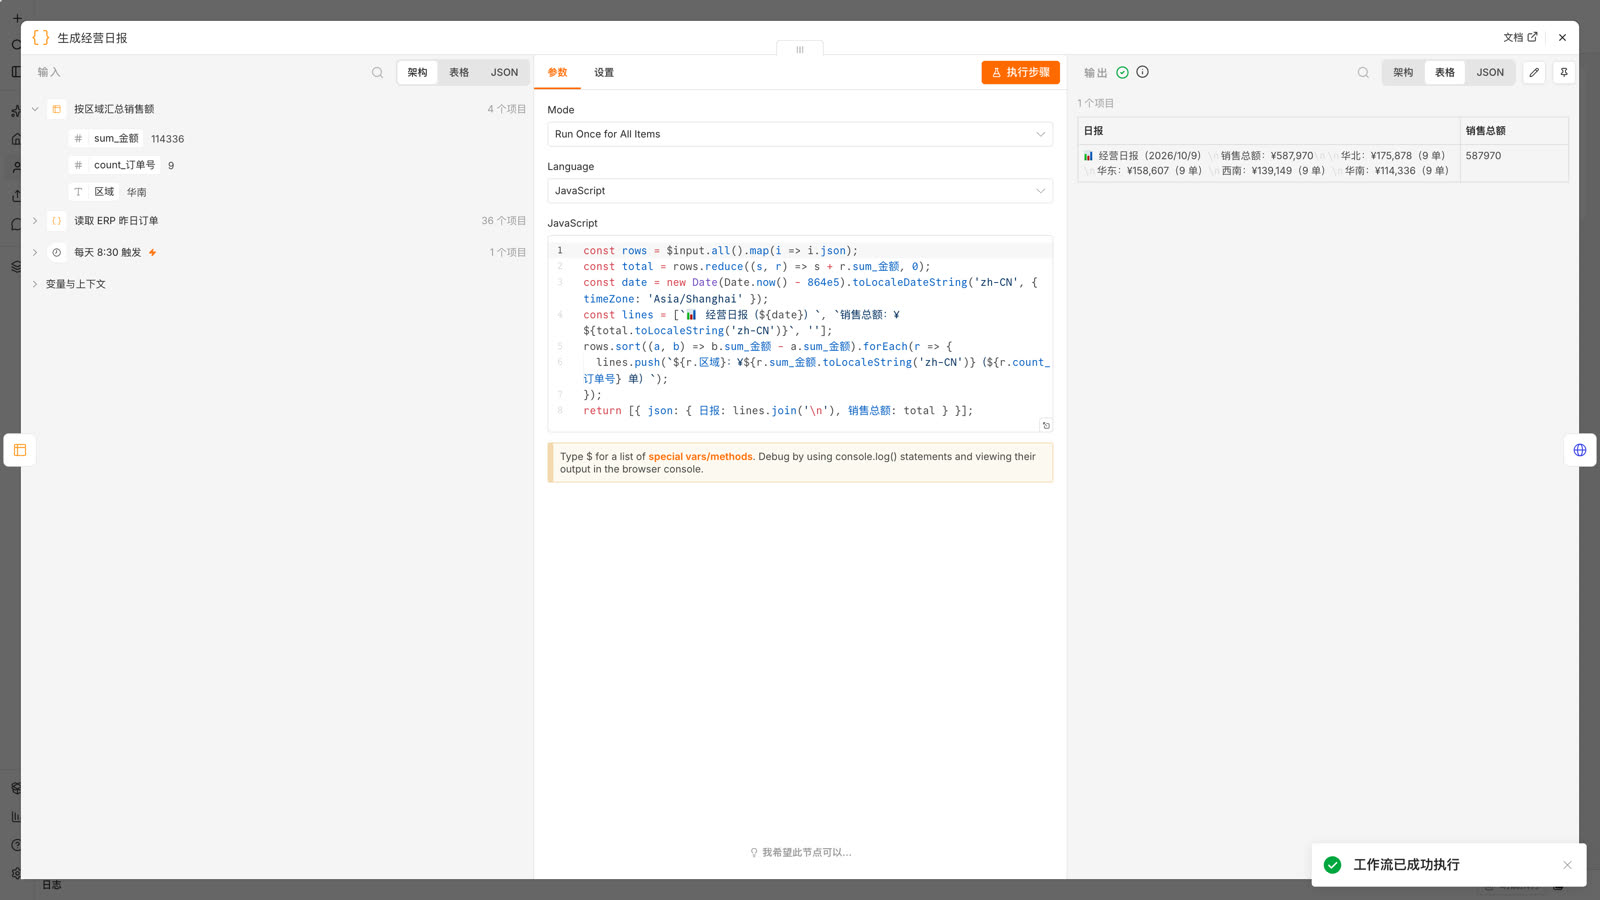
- 添加「代码」节点,把汇总结果拼成日报文字。
- 添加「HTTP 请求」节点,方法选 POST,地址填企业微信群机器人的 Webhook,正文为
{"msgtype":"text","text":{"content":"{{ $json.日报 }}"}}。
运行与查看结果
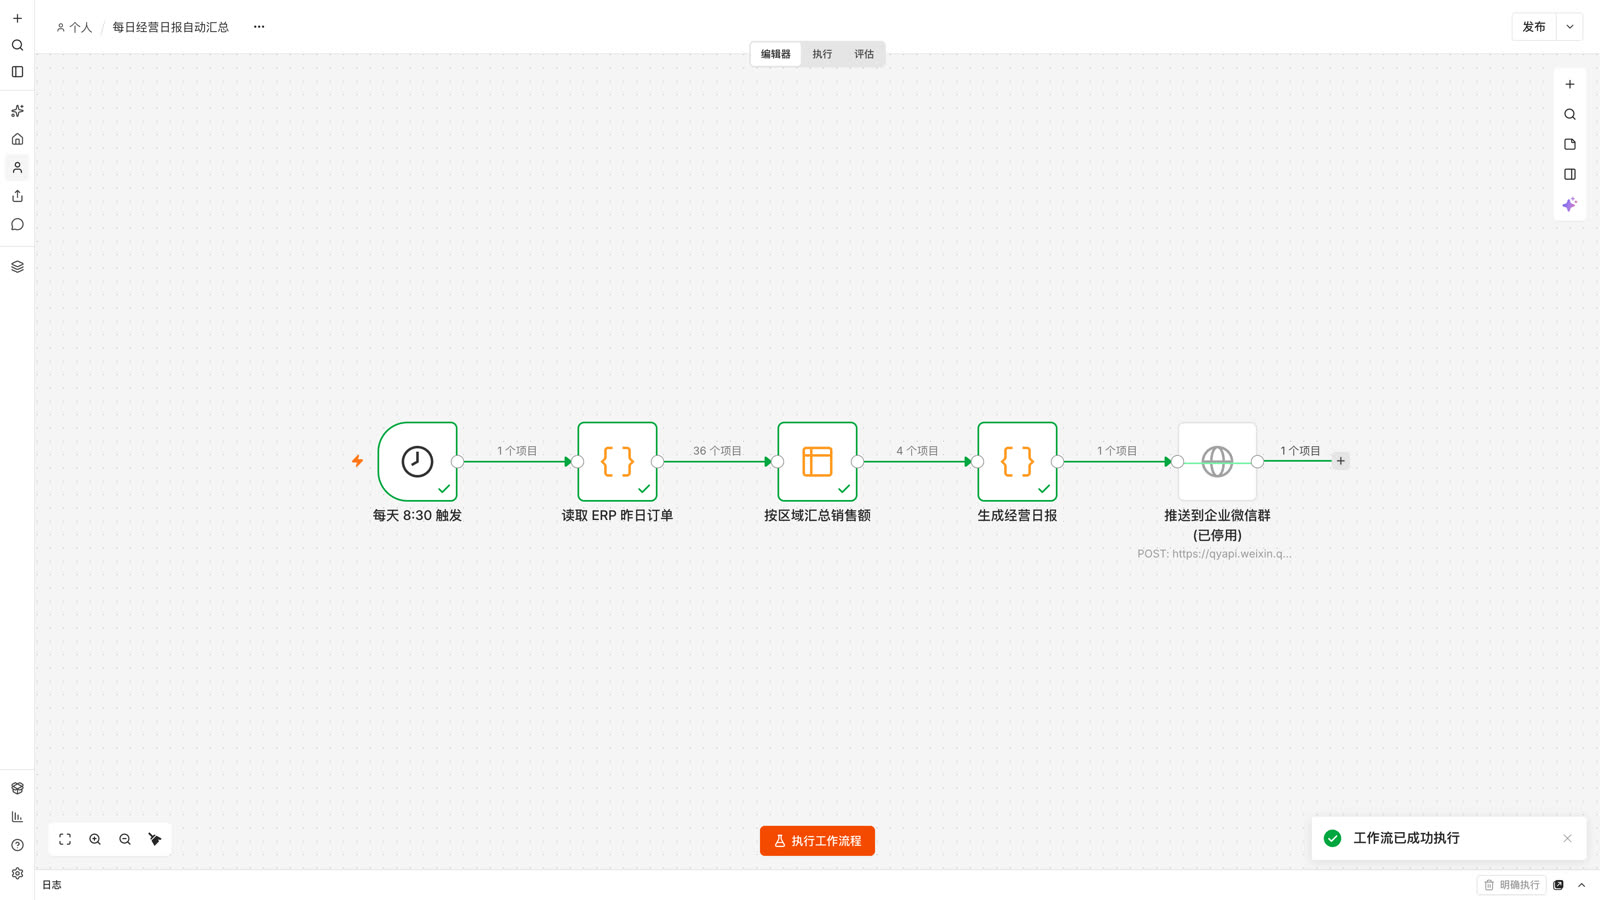
点击画布底部「执行工作流程」,每个节点右下角出现绿色对勾,连线上标注数据条数:36 条订单汇总成 4 个区域,最后生成 1 条日报。
双击任意节点,可以同时看到输入、参数和输出。下图是「生成经营日报」节点,右侧输出就是推送到群里的日报内容。
确认结果无误后,点击右上角「发布」,工作流就会按设定时间自动运行。
接入国产大模型
模型的 API Key 以「凭证」的形式统一保存,加密存储在本地数据库中。工作流里只引用凭证,不会暴露密钥。
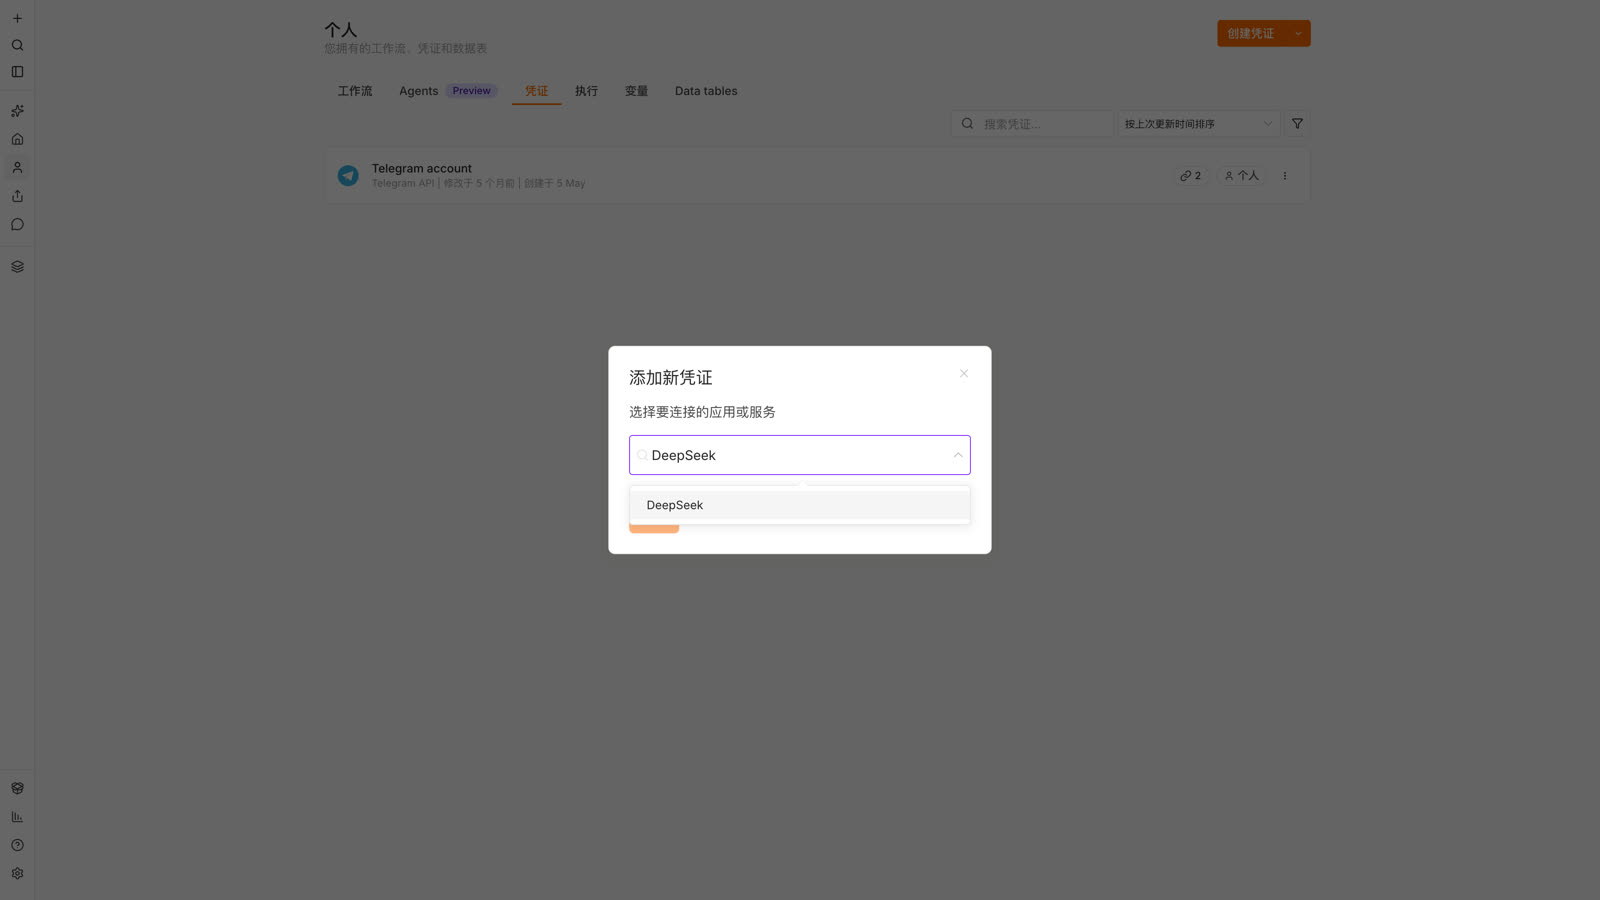
- 概述 → 凭证 → 创建凭证
- 搜索并选择 DeepSeek
- 粘贴 API Key 并保存
其他兼容 OpenAI 接口的模型服务,选择 OpenAI 凭证并修改 Base URL 即可。
示例二:客户询价转报价草稿
销售每天要从询价邮件里摘出规格和数量,再查价目表算价。这个工作流让 AI 先读邮件,规则再计价,金额超过 5 万元的自动转销售经理审批。
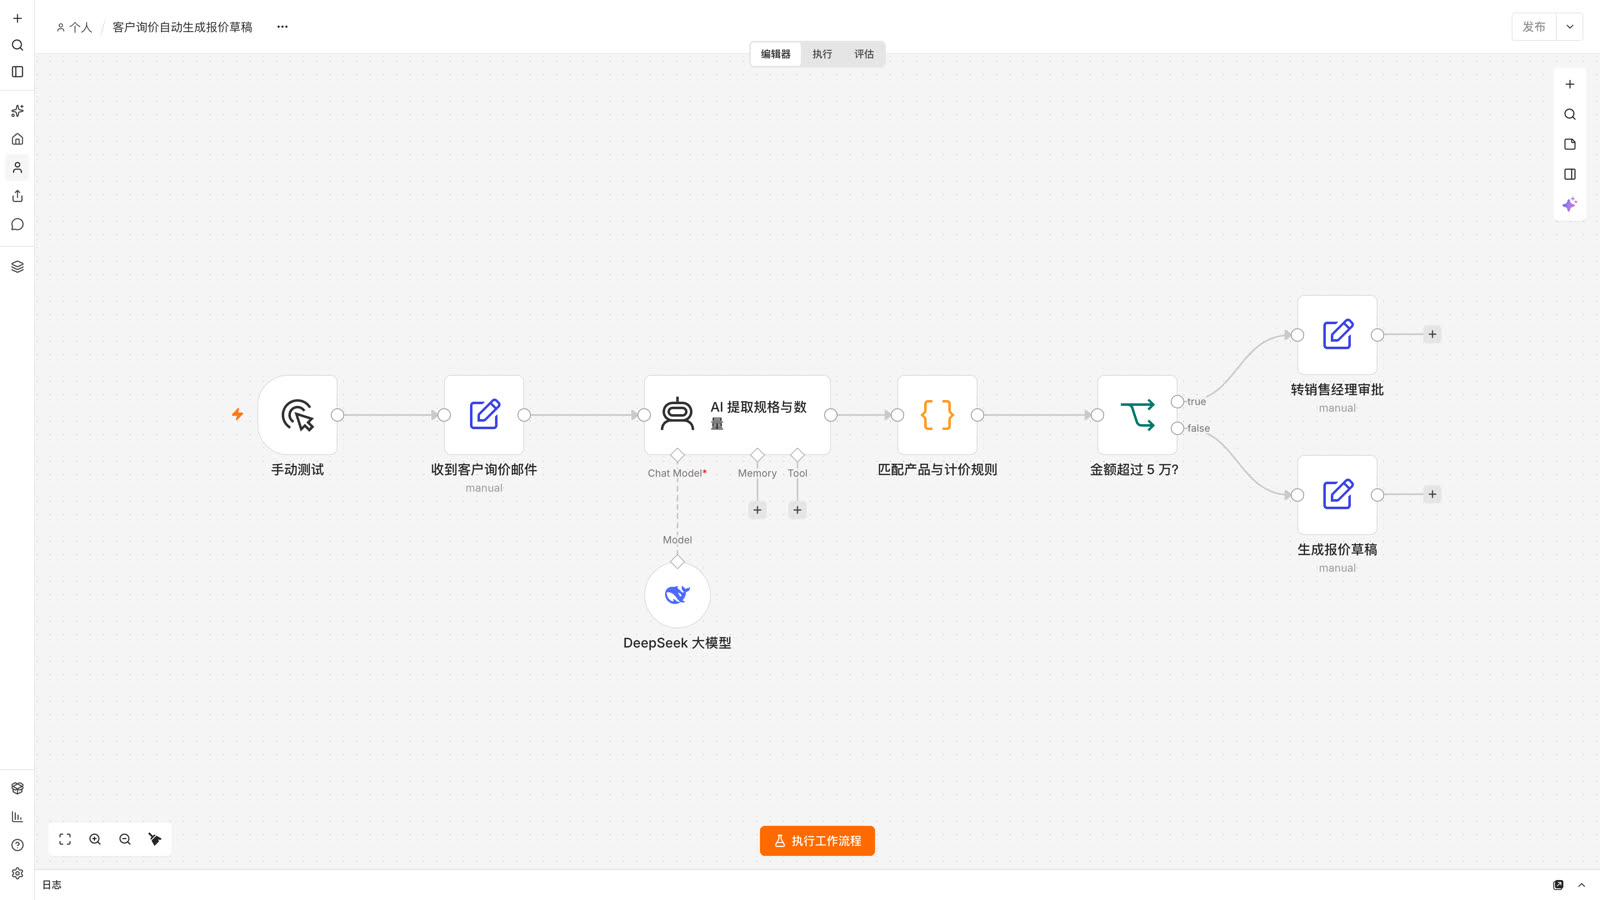
- 触发节点:生产环境用「邮件触发」(IMAP)或「Webhook」接收询价;示例用手动触发加一封示例邮件。
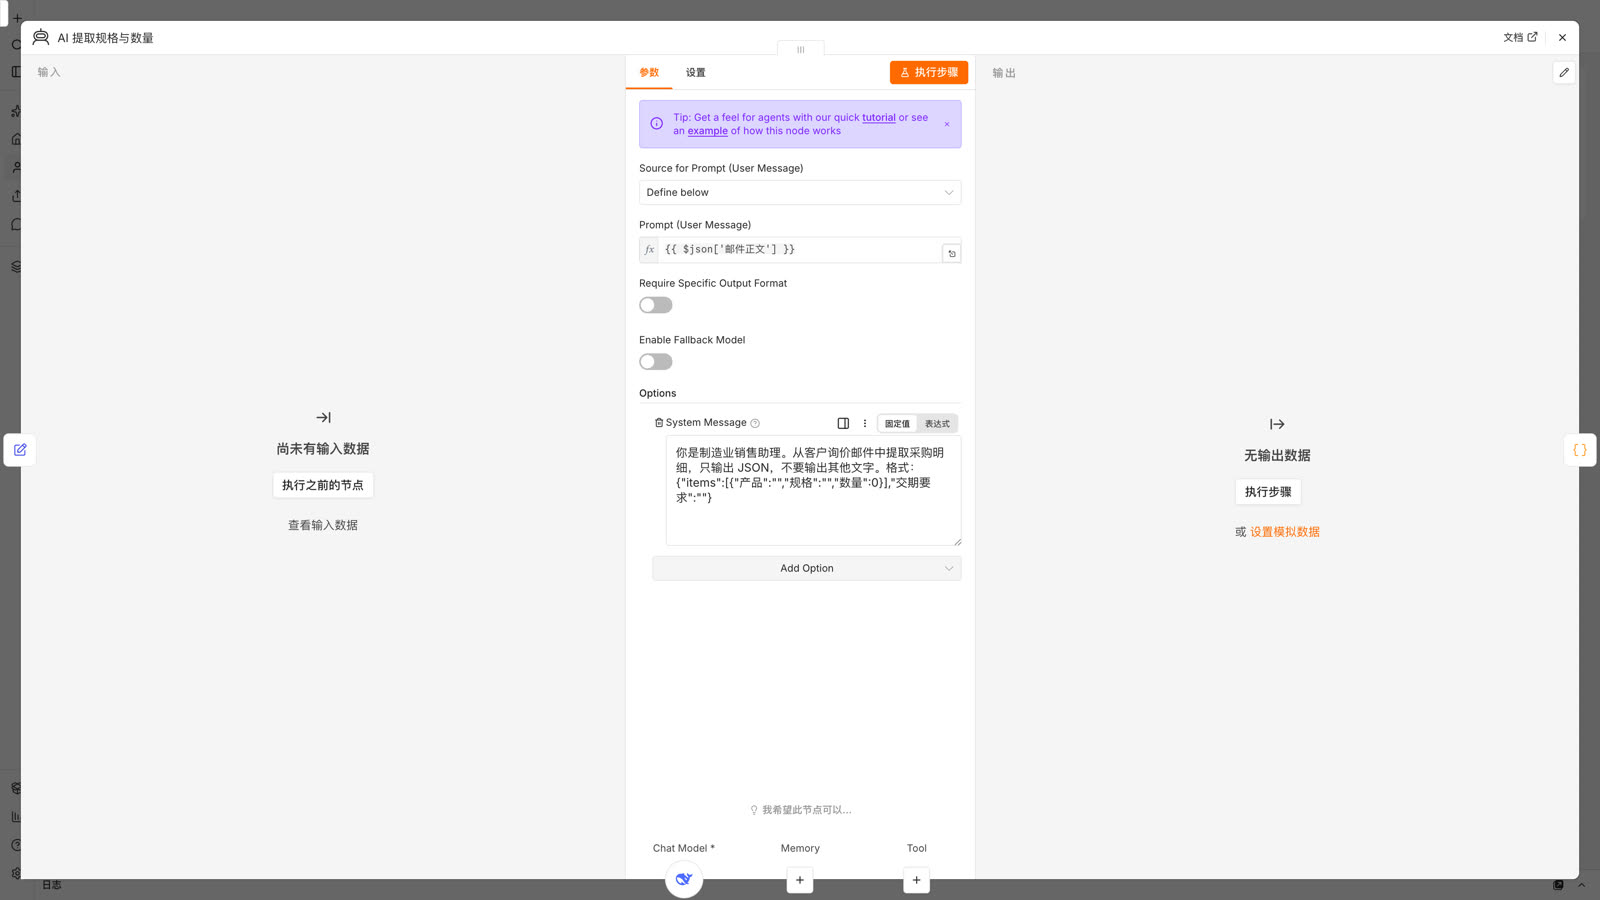
- 添加「AI Agent」节点,提示词来源选「在下方定义」,填入邮件正文;系统消息要求模型只输出 JSON,包含产品、规格、数量和交期。
- 在 AI Agent 下方的 Chat Model 插槽接入「DeepSeek Chat Model」,凭证选上一节创建的 DeepSeek 凭证,模型选
deepseek-chat。 - 「代码」节点按价目表计算单价、小计和合计。价目表可以放在数据表里,由业务人员维护。
- 「If」节点判断合计是否超过 50,000 元,超过的转审批,其余直接生成报价草稿。
AI 只负责理解非结构化的邮件文字,计价和审批阈值由规则节点决定。这样结果可以追溯,业务人员也能自己调整阈值。
用 AI 助手搭建工作流
左侧栏第一个图标是 AI 助手。在输入框里用中文描述要自动化的事情,AI 助手会查找已有的数据表和凭证、提出确认问题、规划节点,再生成工作流。
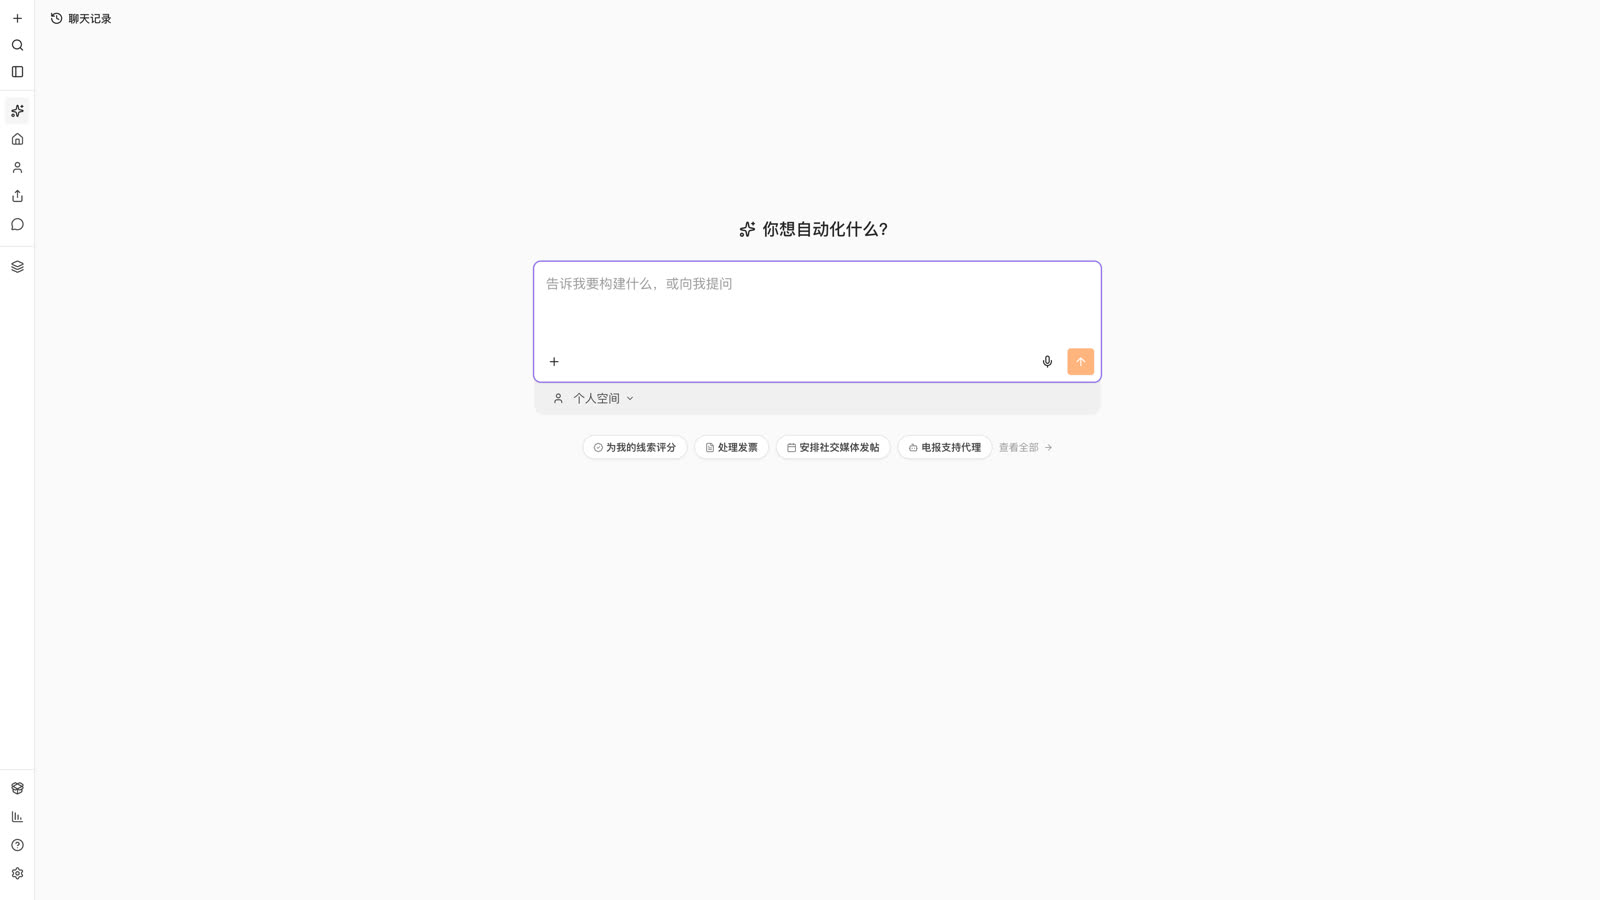
- 写清楚触发时间、数据来源、处理逻辑和输出位置,例如:「每天早上 9 点,从数据表『销售订单』读取昨天的订单,按产品统计销售额,生成一段中文经营摘要,推送到企业微信群机器人」。
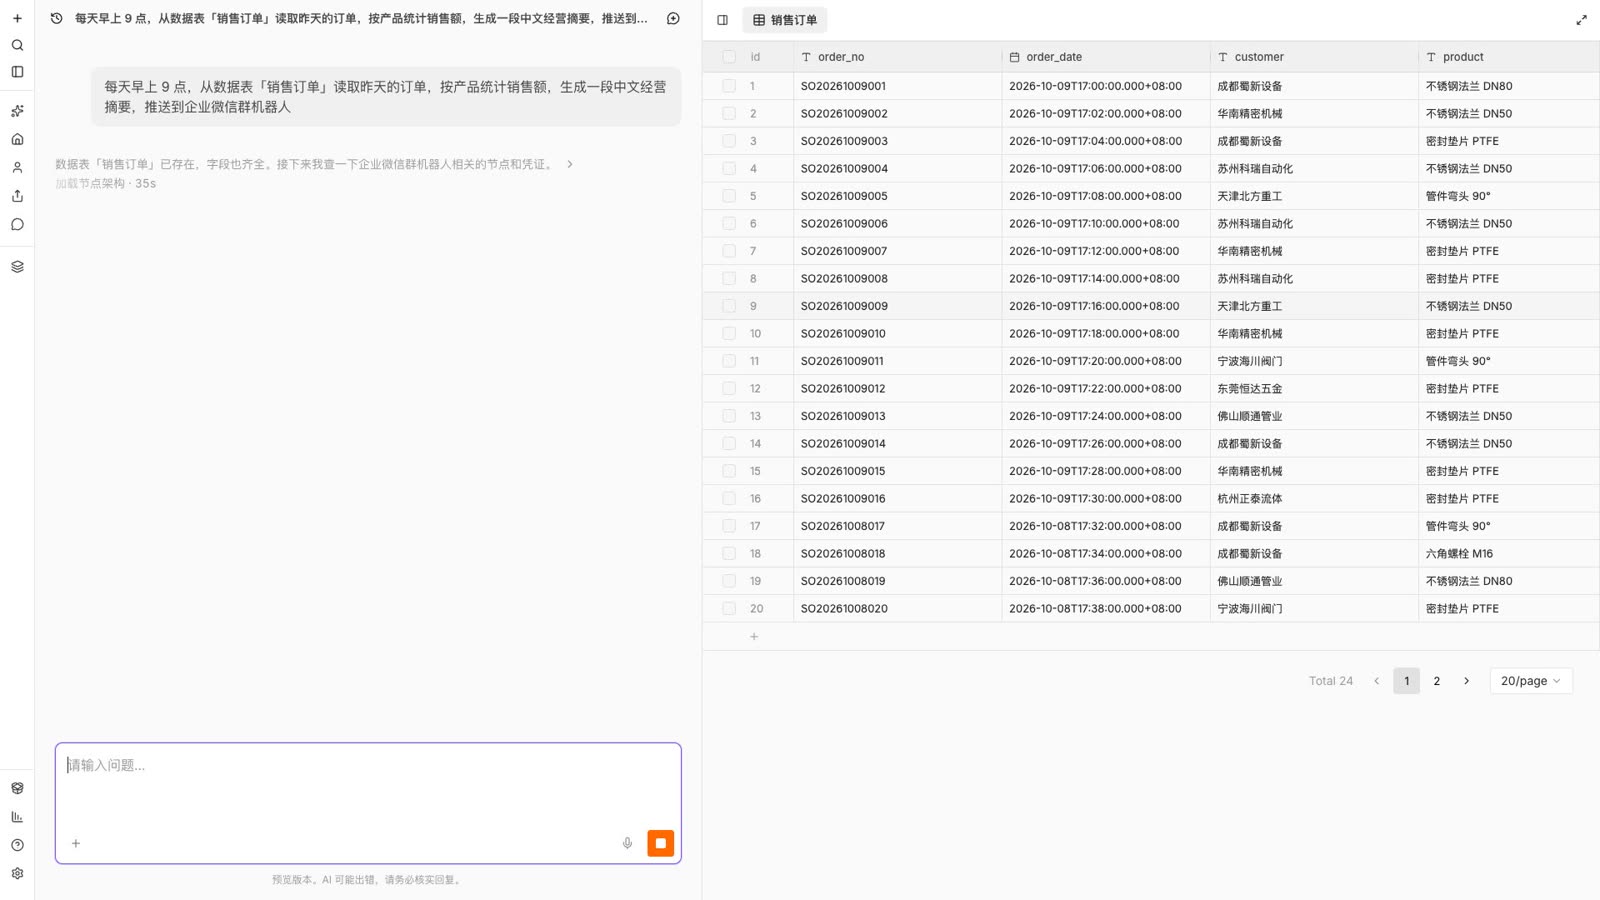
- AI 助手先检查实例里已有的资源。下图中它找到了「销售订单」数据表,并在右侧「产物」区打开预览。
- 信息不全时,AI 助手会用选择题或填空提问,例如订单数据来自有赞、用友、金蝶还是数据表。
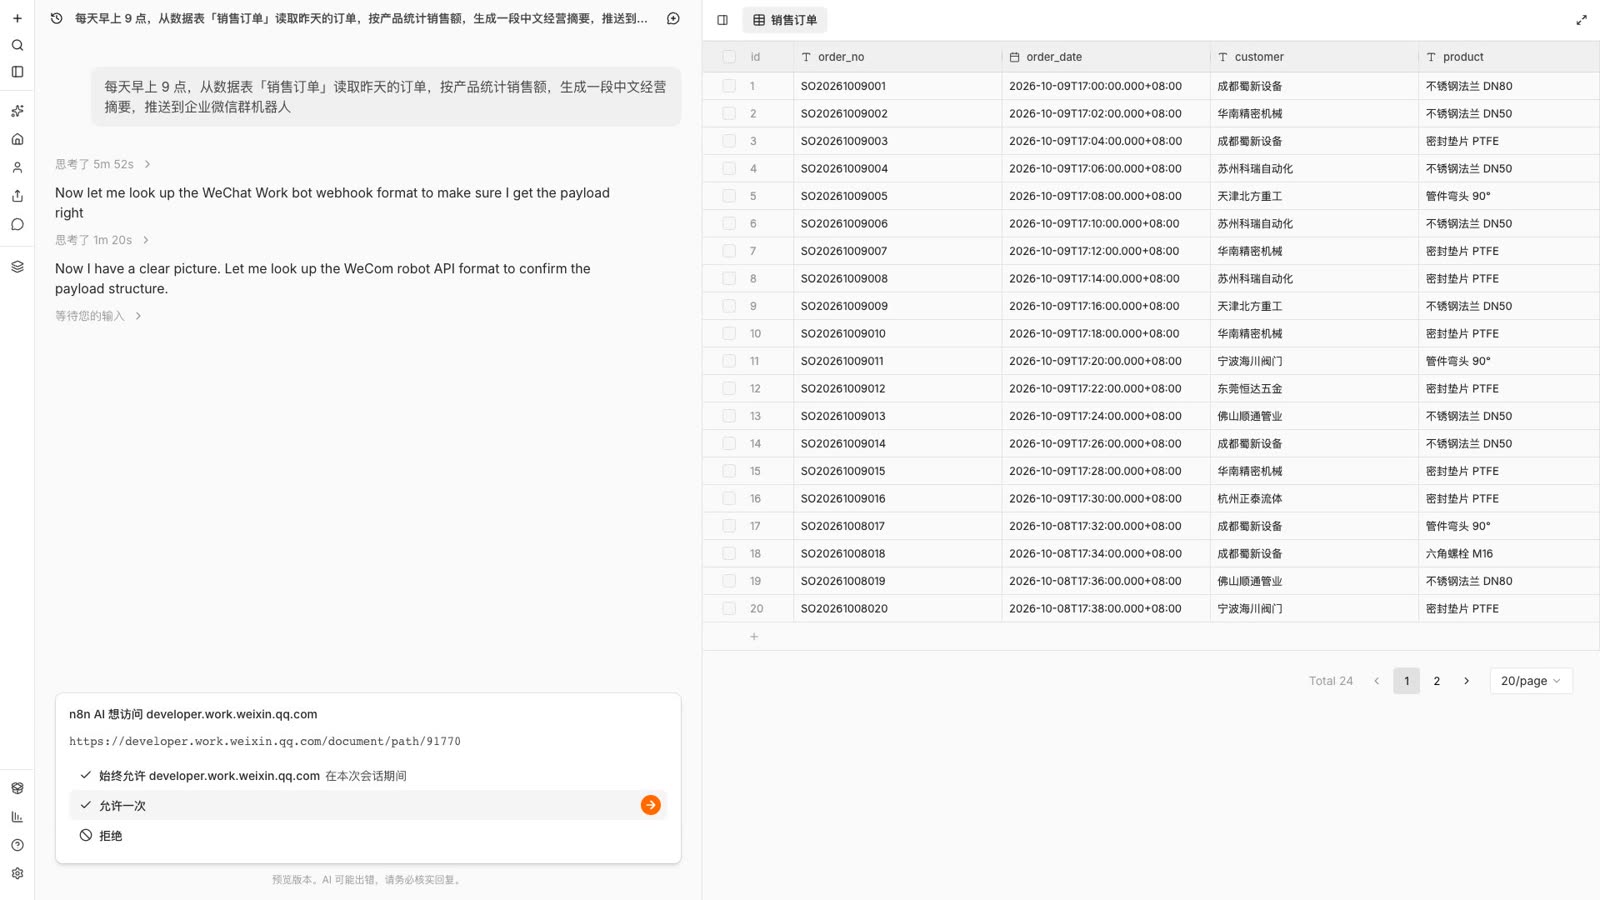
- 访问外部网站、调用工具前,AI 助手会请求许可,可以选「允许一次」「始终允许」或「拒绝」。
- 生成的工作流同样出现在「产物」区,打开后按需修改,测试通过再发布。
管理员可以在「设置 → Assistant」里选择 AI 助手使用的模型、开启网页搜索,并按工作流、凭证、数据表等类别设置哪些操作需要审批。
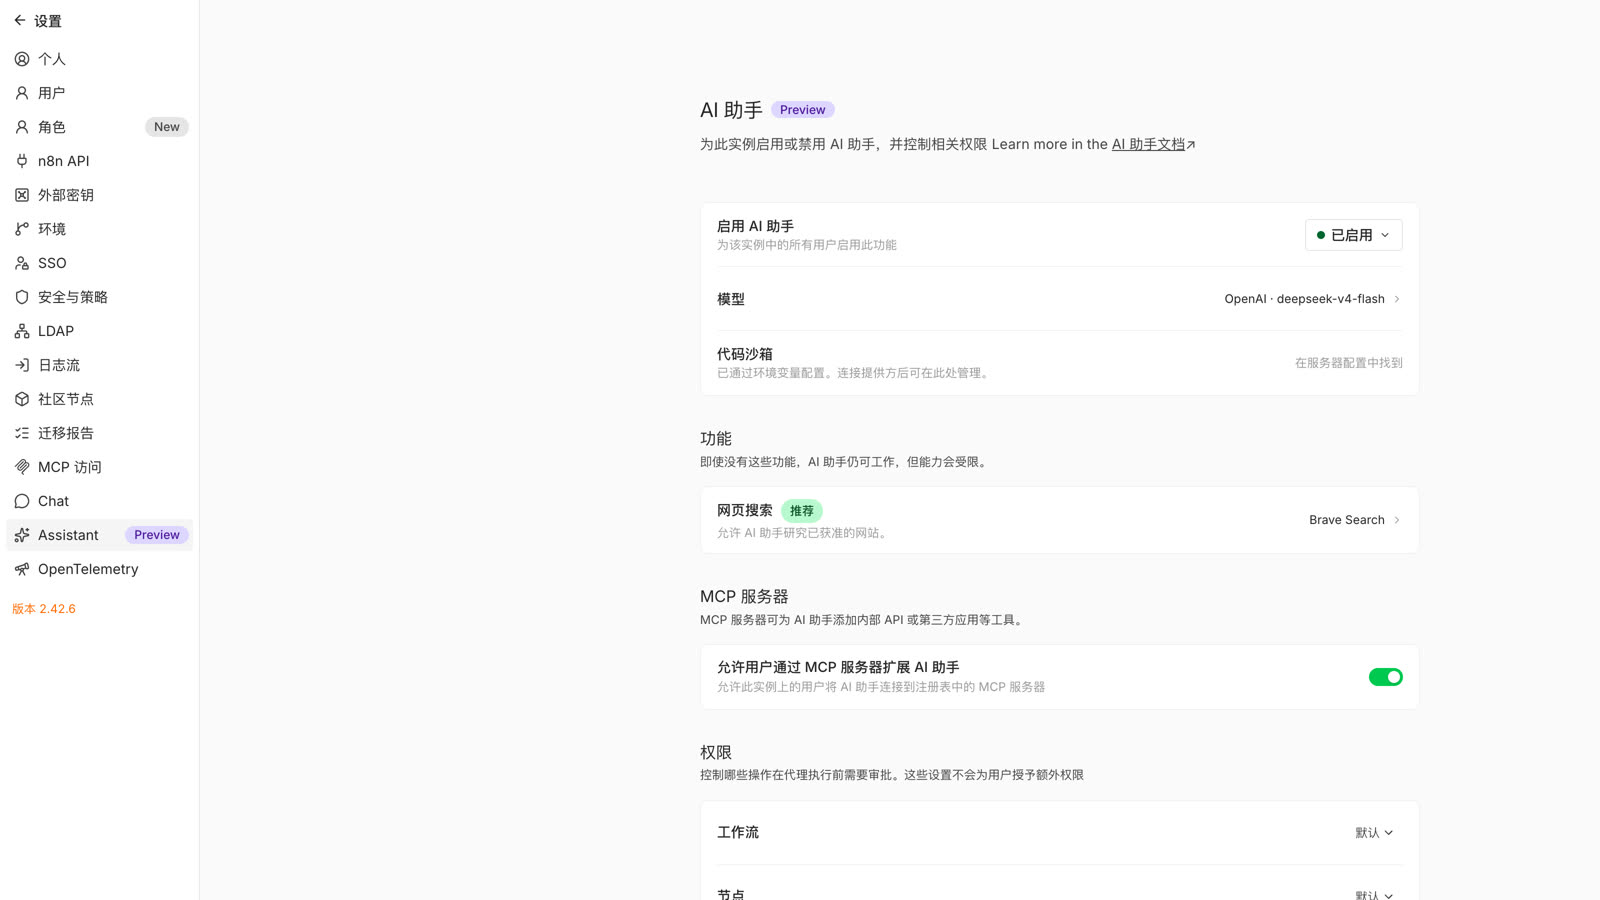
AI 助手目前是预览功能,生成工作流依赖代码沙箱服务。部署时需要使用 docker-compose-sandbox.yml 一并启动 sandbox-api 与 sandbox-runner。搭建一个完整工作流通常需要几分钟,结果需人工检查后再发布。
数据表与执行记录
数据表
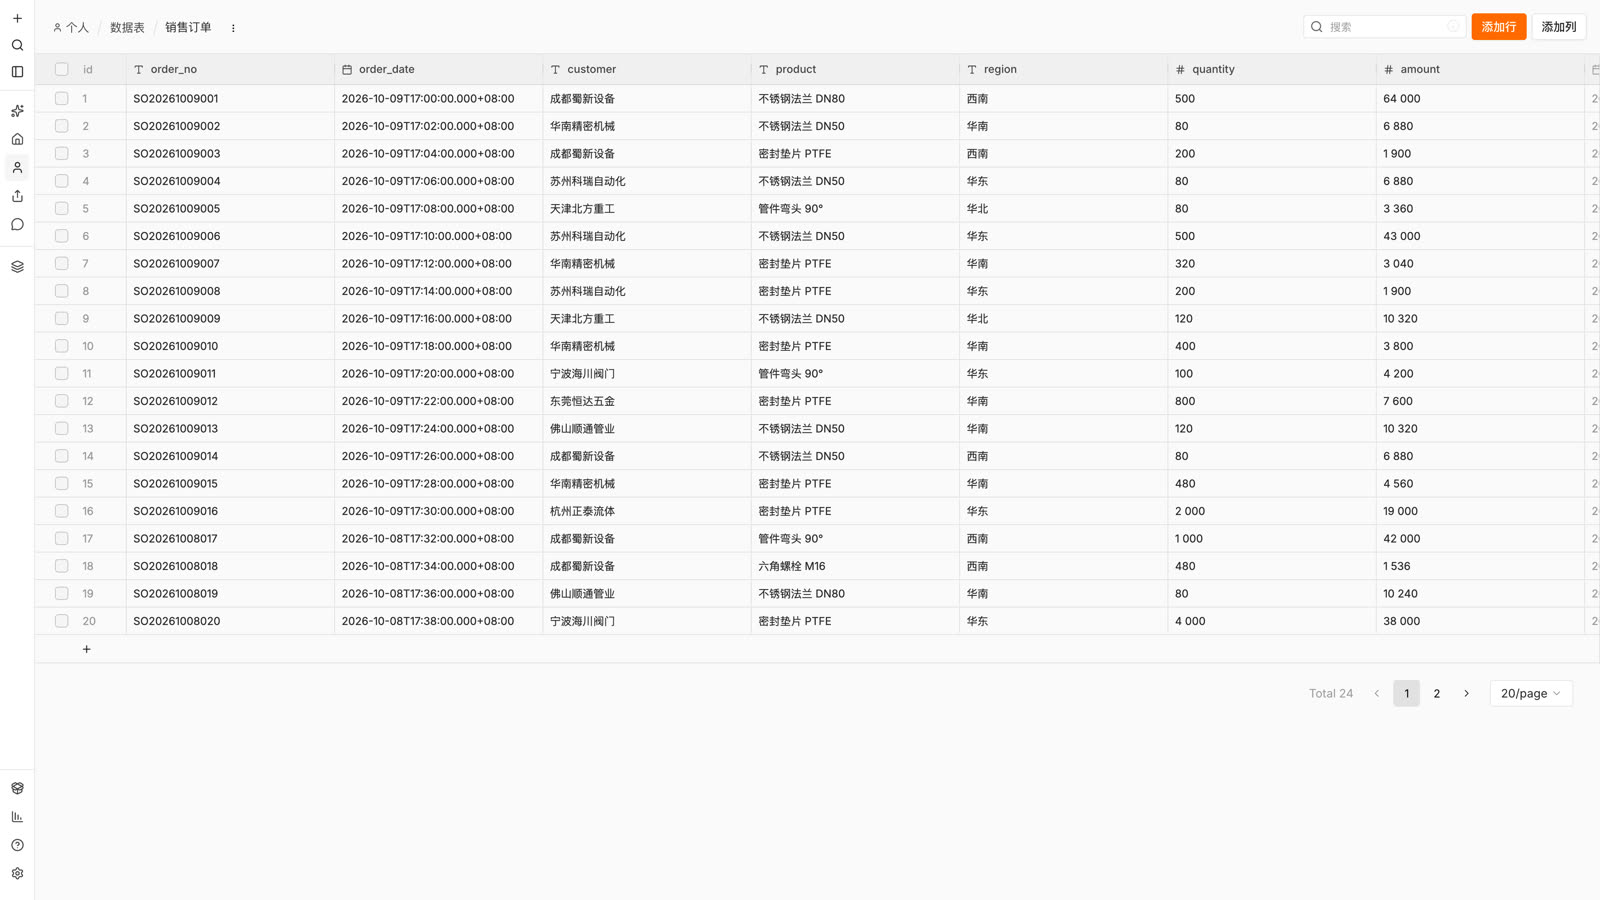
在「概述 → Data tables」里可以创建数据表,存放订单、线索、价目表等。工作流用「Data table」节点读写,业务人员也可以在表格界面直接增改行。图中数据为示例。
执行记录
「概述 → 执行」列出每次运行的状态、开始时间和耗时。点击任意一行,可以回到当时的画布,查看每个节点的输入和输出。失败的执行会标红,并定位到出错的节点。
MCP 与扩展
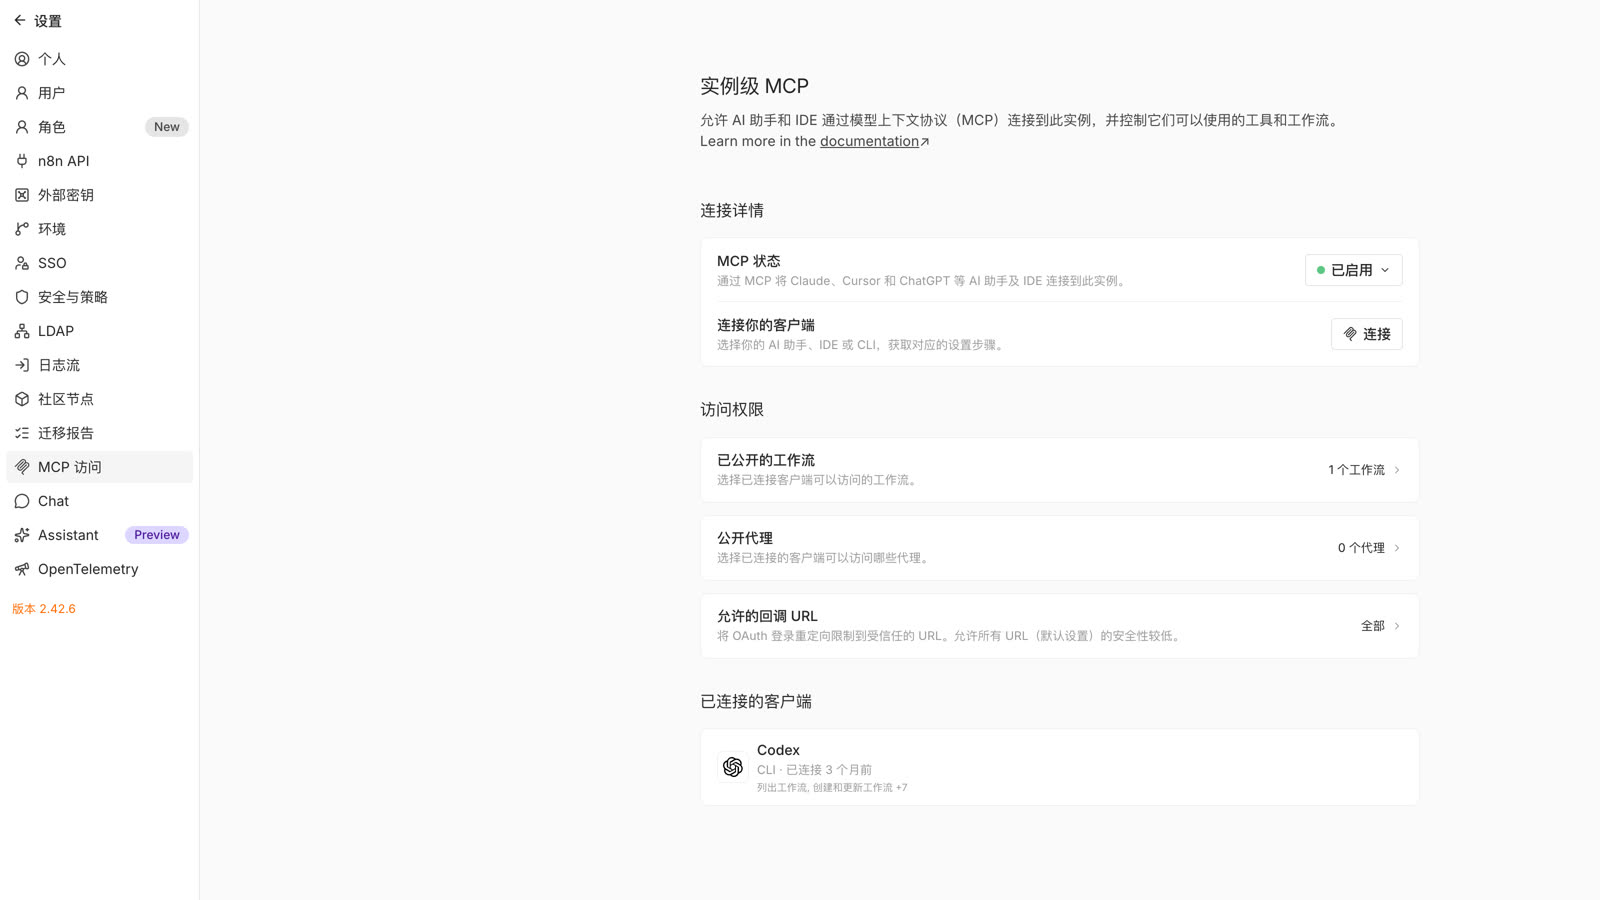
在「设置 → MCP 访问」开启实例级 MCP 后,Claude、Cursor、ChatGPT 等 AI 工具可以连接到本实例,调用你公开的工作流。可以分别控制哪些工作流、哪些代理对外可见,也可以随时撤销某个客户端的访问。
「设置 → 社区节点」可以安装社区节点包,补充飞书、钉钉等国内应用的集成。安装前建议先在测试环境验证。
实施与交付
工程师进驻业务现场,从一个具体流程开始,跑通后交给企业团队。
| 阶段 | 工作内容 | 交付物 |
|---|---|---|
| 业务诊断 | 访谈业务负责人,梳理流程,选出第一个场景 | 流程清单、优先级建议 |
| 流程设计 | 确认数据来源、字段映射、审批节点和异常处理 | 流程设计说明 |
| 部署上线 | 私有化部署,对接 ERP、企业微信与大模型,试运行 | 可运行的工作流、部署文档 |
| 培训交接 | 中文操作培训,讲解日常维护与排错方法 | 操作手册、培训记录 |
试点前共同确定验收指标,例如成功率、人工操作次数和处理时长。交付时说明依赖的系统、凭据管理方式和日常维护责任;上游升级后,回归测试现有工作流和中文界面。
常见问题
数据会发送到外部吗?
平台部署在企业服务器上,可以关闭遥测和版本检查。只有工作流里主动调用的外部服务(例如大模型 API)会收到对应的数据;对数据敏感的场景,可以改用内网部署的模型。
能对接用友、金蝶等国内 ERP 吗?
可以。ERP 提供开放接口的,用「HTTP 请求」节点对接;没有接口的,可以直连数据库,或者通过中间表交换数据。
业务人员能自己维护流程吗?
简单的参数调整,比如时间、阈值、推送的群,可以在中文界面里直接改。涉及新系统对接的变更,建议由经过培训的 IT 人员处理。
后续版本怎么升级?
中文适配版跟随上游版本持续更新。升级前先备份 n8n_data 卷,再执行 docker compose pull 和 docker compose up -d。